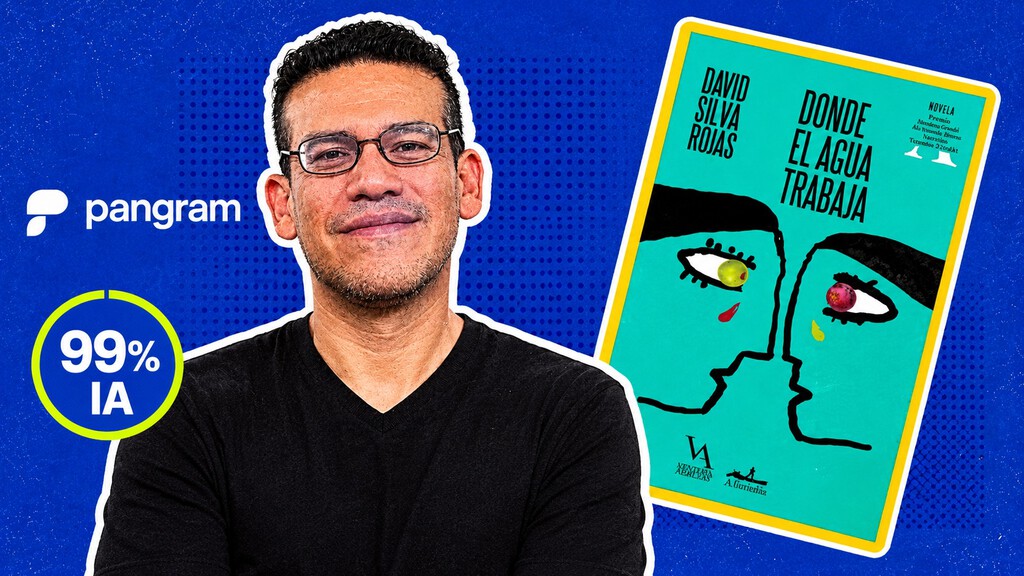
El 23 de octubre, El País publicó que el detector Pangram atribuye a una IA el 99% de ‘Donde el agua trabaja’, ganadora de un premio cuyas bases prohibían usar IA. El autor lo niega y la editorial suspendió las presentaciones mientras revisa el caso. Igual que la obra de Thélyson Orélien 'C'était ça ou mourir' ('Era eso o morir'), la novela de David Silva Roja se centra en la explotación, en el dolor y en la memoria. Fue elegida entre 2.204 manuscritos de 22 países por "la sutileza de su escritura y por el uso magistral de los silencios como recurso compositivo".
En cualquier caso, se ha llevado los 20.000 euros a los que aspiraba el Premio Internacional de Novela Breve Almadía–Ventosa Arrufat y ya está siendo traducida. Y también se han cancelado varias de sus presentaciones. Por supuesto, no vamos a decidir aquí si la novela es o no fruto de la IA. Porque, en realidad, es difícil de valorar. La cuestión es otra: en pocos meses, el programa de una empresa privada se ha convertido en juez de facto de la autoría literaria. ¿Es Pangram el árbitro que necesitamos?
Qué hace, y qué hace bien
Pangram es un clasificador de redes neuronales entrenado con texto humano y texto generado por modelos, con técnicas para reducir los falsos positivos. Puntúa por fragmentos y devuelve un porcentaje: una estimación de cuánto se parece un texto a lo que escribiría una máquina, no una reconstrucción de cómo se escribió.
Según la propia empresa, Pangram 4 detecta el 99,66 % del texto de IA y marca por error el 0,0041 % del humano, un fallo cada 24.000 documentos. Y no lo dice solo la empresa: un estudio de la Universidad de Chicago lo situó por encima de GPTZero y Originality.ai, y El País comprobó que daba 0% en libros anteriores a ChatGPT. En el caso del Goncourt, se confirmó después que el autor había usado IA.
La versión que usó El País, Pangram 4.1, se lanzó el 19 de octubre, cuatro días antes de que se publicara el análisis. Sobre 29.103 pares de textos con ediciones mínimas, los cambios de veredicto no deseados bajan del 1,08% al 0,15%, un problema parecido al que señalaban los experimentos de añadir una coma o un espacio extra (ya lo contamos aquí). Además, devuelve la probabilidad de cada etiqueta (humano, asistido por IA o generado por IA) y muestra menos certeza en textos inferiores a 150 palabras.
 En Xataka Las herramientas para detectar textos hechos con IA son flojas nivel: creen que 'Cien años de soledad' es IA
La empresa cifra sus falsos positivos en un 0,009% en inglés y un 0,0026% en español, pero los mide sobre texto web, no sobre novelas. Los falsos negativos suben ligeramente, del 0,34% al 0,37%. Y la propia ficha admite que su tasa de error no es cero y que un simple error puede causar daño reputacional.
Lo que no hace bien
Nature recoge que, cuando una IA modifica sustancialmente ensayos humanos, Pangram los etiqueta como humanos el 41% de las veces. Engañarlo no es difícil: Jot Down también mostró cómo un espacio añadido cambia el veredicto. Un preprint reciente sostiene que, tras pasar por un “humanizador”, los falsos negativos superan el 96%, justo lo contrario de lo que anuncia la empresa (98,83% de detección frente a 13 humanizadores). Los estudios nunca coinciden.
Hay un límite más sutil. Su CEO explica que la tasa de falsos positivos se mide con millones de textos anteriores a 2022. Entretanto, es de sospechar que muchos escritores habrán aprendido a introducir la IA en sus artículos y esconderla mejor. En general, este es un buen control para novatos, pero no dice cómo puntúa a quien escribe en 2026, tras años de leer y corregir con modelos. Y un porcentaje no revela quién hizo qué: si la IA redactó, corrigió o solo sugirió tramas. Además, el error no es simétrico, ya lo decíamos: un falso positivo puede destruir una reputación y un falso negativo no cuesta nada.
Árbitro con interés comercial
Pangram Labs es una empresa fundada por dos colegas de Brooklyn, y su negocio crece con la desconfianza: según The Decoder, que citaba al New York Times, sus ingresos se multiplicaron por 35 en un año y sus usuarios mensuales pasaron de 2.700 a 120.000 entre junio de 2025 y junio de 2026. Las tasas de error más citadas son suyas. En tanto baja su "intervalo de confianza" parece aumentar su éxito. Pero como indicaba Tim Requarth, hoy por hoy ninguno de sus modelos es capaz de entender las capas y capas por las que pasa un texto real.
 En Xataka Claude: qué es, cómo funciona y en qué es mejor (y en qué no) que ChatGPT y la competencia
El estudio de Chicago es independiente (lo financian la universidad y un programa de Google Cloud, no Pangram), pero GPTZero asegura que, con ese mismo banco de pruebas, ahora supera a Pangram. No hay estándar: cada proveedor elige métrica, umbral y corpus. Y tampoco hay protocolo. El caso Goncourt empezó con una cuenta anónima en X que pasó fragmentos por Pangram. La Academia pidió prudencia y verificar la fiabilidad del software. Hoy cualquiera puede abrir un caso sin umbral definido ni derecho a réplica, en pleno ruido de “maldita IA”.
¿Y si llega a juicio?
A día de hoy no existe ninguna sentencia española sobre el valor probatorio de estos detectores. En el proceso penal, la admisibilidad depende de la pertinencia y el juez valora la prueba libremente. Un informe de Pangram tendría que entrar como dictamen pericial, con un experto capaz de explicar el método, el margen de error y someterse a contrainterrogatorio.
 En Xataka “Claude puede no ser el autor original”: la nueva marca invisible de Anthropic es una idea estupendamente imperfecta
Solo ahí ya tenemos tres problemas. Es una caja negra neuronal que no explica por qué marca una frase; la tasa de error la declara el fabricante; y sus modelos cambian (Pangram 3 tenía fecha de retirada el 30 de septiembre), lo que complica reproducir un veredicto meses después. Lo más probable es que sirva de indicio para pedir borradores, no como prueba de cargo por sí sola.
Qué exigiríamos a un árbitro
Si necesitamos un juez de lo que es IA, debería ser fiable, estar auditado, tener validez legal y ser neutral. Pangram es hoy, con diferencia, el detector mejor valorado. Aun así, está lejos de ser infalible. Sus auditorías pertenecen al terreno de lo académico, no están sostenidas por auditoría pública y recurrente con acceso al modelo. Ninguna norma reconoce su validez legal y hay conflicto de intereses en tanto es la propia empresa la cual defiende su herramienta.
Europa avanza por otro lado. El artículo 50 del AI Act obliga a los proveedores de IA generativa a marcar sus resultados en formato legible por máquina (con plazo hasta el 2 de diciembre de 2026 para los sistemas ya en el mercado), y la Comisión publicó el 10 de junio un código de buenas prácticas. Pero una marca de agua no prueba nada por sí sola y no cubre texto de modelos abiertos ni reescrito. Falta un auditor independiente, público y europeo que mida estos detectores con pruebas abiertas y comparables. Lo que tenemos ni se acerca a eso.
Imágenes | Montaje elaborado recurriendo a ChatGPT
- La noticia Quién vigila al vigilante: los límites de Pangram como árbitro de lo que es IA y lo que no fue publicada originalmente en Xataka por Isra Fdez .